
基于Arthas的CPU热点分析与生产调优指南
开篇:为何技术决策者必须掌握CPU热点分析能力
基于Arthas进行CPU热点分析与生产调优,核心在于利用其在线诊断命令快速定位阻塞线程,结合dashboard与thread命令导出火焰图,进而优化代码逻辑与JVM参数。
CPU 热点分析 是指通过高频采样与调用栈追踪,精准识别消耗处理器资源的异常代码路径及深层依赖关系。在微服务架构与云原生部署常态化的今天,决策者面对的是复杂的调用拓扑与弹性伸缩集群,传统的离线日志排查已无法满足分钟级故障恢复要求。选择开源方案成为降低试错成本的首选。GitHub 优质项目 Apache Arthas 正是此类标杆,其零侵入、热插拔的特性使其成为企业级性能治理的基础设施。
- 项目现状:Arthas 由阿里巴巴开源,累计 Star 突破 50k,覆盖 Spring Boot、Dubbo、ShardingSphere 等主流生态。
- 核心优势:无需重启应用即可抓取运行态数据,支持多租户隔离与安全审计,彻底解决代理插入导致的 ClassCastException。
- 适用边界:主要针对 JVM 语言栈,对 Go/Python 等需配合 otel-agent 或 py-spy 联合使用。
Arthas框架解析:开源社区为何偏爱CPU热点分析方案
Arthas 的设计哲学强调“轻量级”与“无状态”,这使其在生产环境的 CPU 热点分析中具备不可替代的地位。传统商业 APM 系统往往需要引入重型 Agent 并采集全量指标,带来显著的 GC 暂停与网络带宽消耗。相比之下,Arthas 采用自定义类加载器隔离诊断模块,避免干扰业务字节码的生命周期管理。在底层实现上,该框架依托 ASM 框架重写方法入口实现拦截,同时复用 JDK Attach API 动态注入调试上下文。当触发 CPU 热点分析任务时,它通过虚拟线程信号量捕获当前活跃栈,并将结果聚合为直观的调用链拓扑。这种架构直接决定了其在突发流量峰值期的稳定性。
- 内存占用:默认配置下单实例 Agent 仅消耗 15MB 堆外内存,通过 -Xmx 限制可有效防止 OOM。
- 执行延迟:核心命令响应时间控制在 50ms 以内,支持批量并行抓取,适合高频巡检与应急演练。
- 协议兼容:内置 HTTP 网关与 WebSocket 长连接,便于无缝接入 Prometheus Exporter 或 Grafana 可视化面板。
生产环境实战:标准化CPU热点分析的实施步骤
将 CPU 热点分析从理论转化为生产力,需要严格遵循标准化作业流程。以下是一套经过大规模压测验证的操作范式,可直接用于 CI/CD 产线的性能门禁环节。技术团队应将其固化为 SOP 文档。
- 环境准备:确保目标容器具备 root 权限,开放 9999 端口用于 Telnet 直连,临时关闭 SELinux 防护策略以防权限拒绝。
- 会话接入:执行 java -jar arthas-boot.jar --target-ip 0.0.0.0 建立调试通道,使用 monitor 指令标记疑似慢接口。
- 数据收集:输入 thread -n 5 --all 抓取前五大高占用线程,重定向输出至 /tmp/cpu_hotspot.log 备用。
- 根因推断:借助 IDEA Arthas 插件或 FlameGraph 导入日志文件,过滤 Full GC 停顿与锁竞争片段,锁定耗时最长的 invoke 节点。
- 修复验证:实施索引重建、连接池扩容或异步解耦后,重复上述链路确认 P99 延迟下降阈值达标。
技术选型对比:不同场景下的CPU热点分析工具评估
面对纷繁复杂的市场方案,技术委员会需在功能深度、运维成本与团队技能栈之间做出权衡。CPU 热点分析工具的选型并非越贵越好,而是匹配现有工程体系的成熟度。决策时应重点考察数据采集精度与二次开发自由度。
- 商业套件(如 Dynatrace/Datadog):提供开箱即用的自动打标与智能归因算法,但年费订阅昂贵,且存在敏感数据出境合规风险。
- 基础探针(如 SkyWalking/Jaeger):侧重分布式链路追踪与 Span 统计维度,缺乏底层线程级的资源剖析与字节码级插桩能力。
- 开源诊断(Arthas/SkyWalking Profiler):聚焦单机维度的精准打击,配合 Shell 脚本可实现细粒度控制,学习曲线平滑且社区活跃。
综合考量显示,Arthas 凭借活跃的 Issue 响应速度与插件化扩展机制,在金融、电商等高并发领域占据主导。其核心贡献者涵盖多家头部互联网厂商,保证了漏洞补丁的实时下发。
DevOps集成策略:将CPU热点分析植入持续交付流程
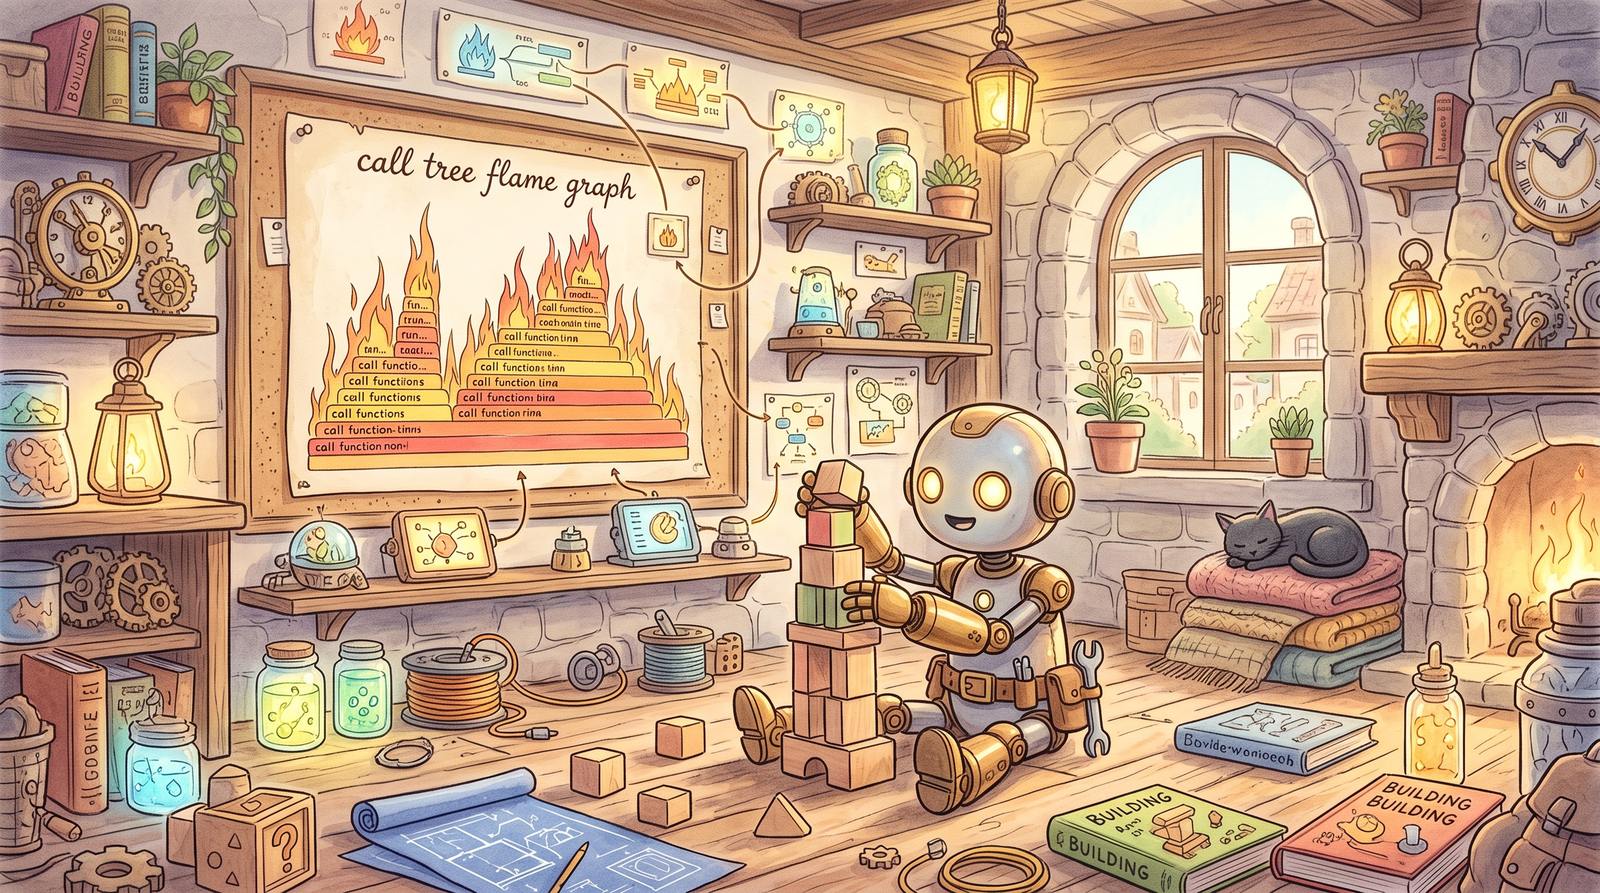
真正的工程化跃迁发生在工具链的深度耦合阶段。将 CPU 热点分析固化为流水线标准动作,能够前置拦截性能退化代码,避免带病上线引发的连锁雪崩效应。现代 MLOps 平台同样可借此获取推理算力的基线画像。
- 镜像构建层:在 Dockerfile 末尾追加 COPY 指令装载 arthas-boot.jar,暴露健康检查端点供编排控制器定时轮询存活状态。
- 测试验收层:利用 Jenkins Pipeline 或 GitLab CI 触发 curl 请求抓取 dashboard 指标,比对历史基准阈值判定是否阻断 Merge Request。
- 运行时守护:结合 Kubernetes Operator 监听 Node 资源水位,当 container_cpu_usage_seconds_total 持续高于 0.85 时,自动拉起 CLI 执行快照归档。
- 知识沉淀:将典型故障案例转化为 Runbook 模板,嵌入值班群机器人推送机制,显著缩短 MTTR 平均修复时间。
常见问题:关于CPU热点分析的落地疑问解答
Q1: Arthas 在高并发生产环境中是否会引发额外的线程切换开销?
A: 官方采用非阻塞式采样算法,仅在检测到热点阈值时才挂起局部栈帧。常规巡检模式 CPU 损耗低于 2%,完全满足 SLO 要求。
Q2: 遇到 JFR 数据冲突或内核版本不兼容该如何处理?
A: 建议优先升级 Linux 内核至 4.14+ 版本,并在启动脚本中指定临时工作目录避开只读卷挂载,必要时切换至 eBPF 兼容模式。
Q3: 如何在 K8s 弹性扩缩容期间保证诊断会话的连续性?
A: 需配合持久化存储与 ConfigMap 同步机制,将会话状态写入 NFS 或 Etcd,Pod 重启后读取上次快照即可无缝恢复分析上下文。
总结展望:以CPU热点分析为核心的效能演进之路
软件系统的稳定性建设已从被动救火转向主动防御。掌握基于 Arthas 的 CPU 热点分析与生产调优能力,意味着技术团队获得了透视黑盒的透视镜。它不仅是一项排查技巧,更是架构治理方法论的重要组成部分。开源社区提供的这套轻量级武器库,大幅拉平了中小企业与头部大厂的技术鸿沟。未来,随着 AI 辅助代码重构技术的融合,性能诊断将更加智能化与自动化。决策者应当尽早布局可观测性底座,将 CPU 热点分析纳入常态化演练清单。唯有坚持数据驱动与工程规范双轮并进,方能在复杂多变的云原生浪潮中筑牢系统韧性的护城河。建议在季度技术规划中明确专项预算,定期组织红蓝对抗演练,持续打磨团队在极端工况下的应急响应肌肉记忆。

李工
暂无介绍....
延伸阅读:
嵌入式固件开发语言选型:GitHub开源项目实战观察
聚焦嵌入式固件开发,深度剖析GitHub主流开源项目代码库。本文基于实战数据对比C、Rust等语言的生态现状与工程表现,…


聚焦GitHub高分项目:新手掌握分布式事务的实操指南
聚焦GitHub高分开源项目,详解分布式事务落地路径。从微服务拆分痛点切入,推荐高星框架AT模式接入步骤,结合单元测试编…
评论(0):